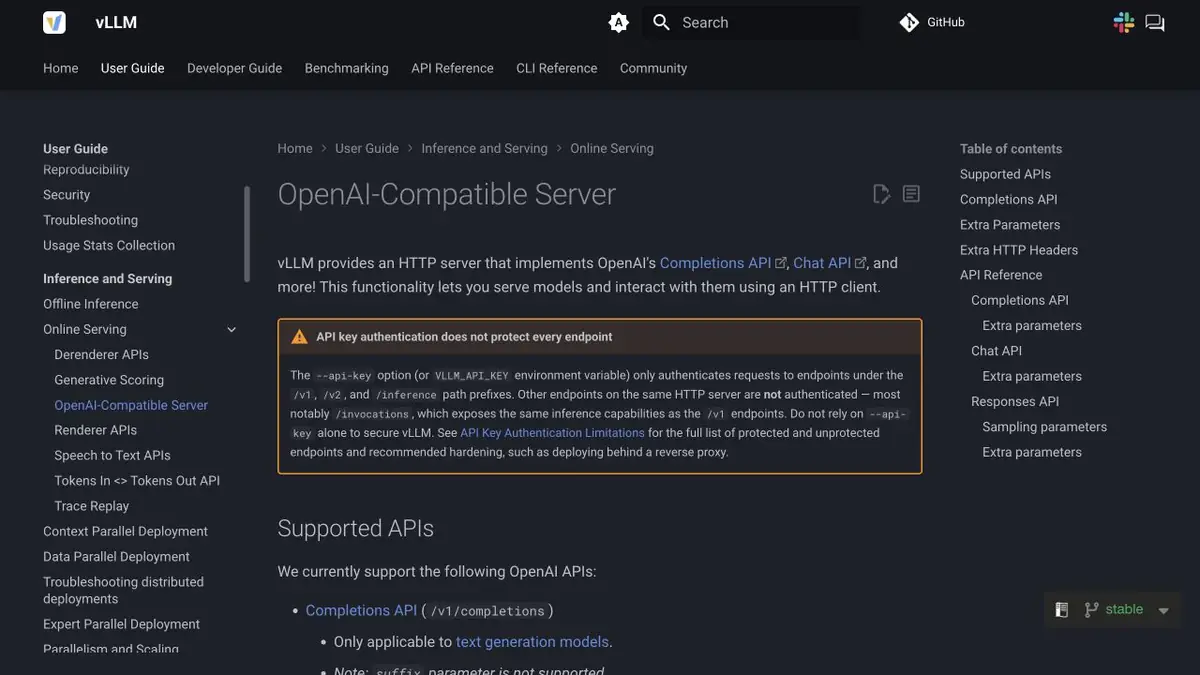
Le moteur exécute le modèle sur l'équipement préparé et répond aux appels de plusieurs clients. Le serveur implémente une partie des interfaces OpenAI API.
D'abord un itinéraire
Imaginez un service qui traite les appels de la file d'attente une fois par heure. Un modèle pris en charge et l'itinéraire utilisé par l'application suffisent pour le prototype. vLLM lève le serveur HTTP, de sorte que le modèle peut être vérifié par le même client que celui de la version de test. Commencez par une courte demande et fixez le formulaire de réponse attendu. Si le client a besoin d'appeler la fonction, vérifiez-la. La prise en charge du texte brut ne confirme pas le fonctionnement des outils.
Pourquoi une réponse rapide ne dit pas grand-chose
La charge dans la file d'attente est inégale. Soumettez quelques appels courts avec un long et comparez le temps avant que la réponse ne commence et le temps de traitement complet. Notez la taille des entrées et des sorties. Ainsi, vous pouvez voir si l'attente est liée à la lecture d'un grand contexte ou à la génération elle-même. Si les paramètres sont pris à partir des fichiers du modèle, cochez cette case pour ne pas prendre la modification des paramètres comme une différence de moteur.
Restrictions d'occupation
Comparez le modèle et son format avec la documentation vLLM, puis vérifiez le comportement de connexion qui ne correspond pas au contexte. N'ouvrez pas le serveur de formation. La documentation décrit séparément les limites d'action de la clé d'accès intégrée. La protection du réseau et les règles d'accès seront nécessaires avant le test sur les données de travail, même si l'application est déjà capable d'envoyer des requêtes et de lire le flux de réponse. Vérifiez séparément que le redémarrage ramène le serveur à l'état initial attendu.
Pour quelles tâches convient-il
- Connecter un client existant à votre modèle
- Mesurer la latence pour plusieurs requêtes simultanées
Les points forts
- Prend en charge le traitement par lots des demandes entrantes
- La documentation du serveur et la compatibilité des modèles
Limites
- La compatibilité de l'interface dépend du parcours et du modèle
- Le déploiement nécessite un contrôle de la mémoire et de l'accès au réseau
Choix et conditions
- Mode gratuit
- Oui
- Période d'essai
- Non confirmé
- Sans inscription
- Non confirmé
- Interface en russe
- Non confirmé
- Installation locale
- Oui
- API
- Oui
« Non confirmé » signifie que les informations disponibles ne suffisent pas. La fonctionnalité peut exister ; vérifiez les conditions du développeur.
- Formats d’entrée
- Texte, Code
- Résultat
- Texte, Données
Conditions
Il n'y a pas d'abonnement séparé pour l'utilisation du moteur ouvert. La licence du modèle et les ressources informatiques sont comptabilisées séparément. La compatibilité de l'interface dépend de l'itinéraire et du modèle.De la tâche au premier résultat
Exemple pratique
- Tâche
- Connecter un client existant à votre modèle
- Que préparer
- Modèle pris en charge, serveur de test et un petit ensemble de requêtes courtes et longues.
Consigne ou requête
Lancez le modèle sur le serveur de test. Comparez les réponses et le temps d'attente pour une requête et un groupe d'appels simultanés.
Résultat attendu
Tableau des retards, des erreurs et des paramètres de démarrage avec les entrées enregistrées.
Comment vérifier le résultat
- Vérifiez les paramètres de génération et la version des poids avant la comparaison.
- Vérifiez la requête longue et répétez après une erreur sans accès à partir d'un réseau ouvert.
Cet exemple pédagogique préparé par la rédaction décrit une tâche ; il ne présente pas le résultat d’un test personnel du service. Vérifiez la disponibilité du mode requis, les droits sur les fichiers d’origine et les conditions d’utilisation du résultat.
Vérifier les détails
Sources officielles
La description est faite à partir des matériaux du développeur. Les fonctionnalités, les prix et la disponibilité peuvent varier; vérifiez la source avant de l'utiliser.