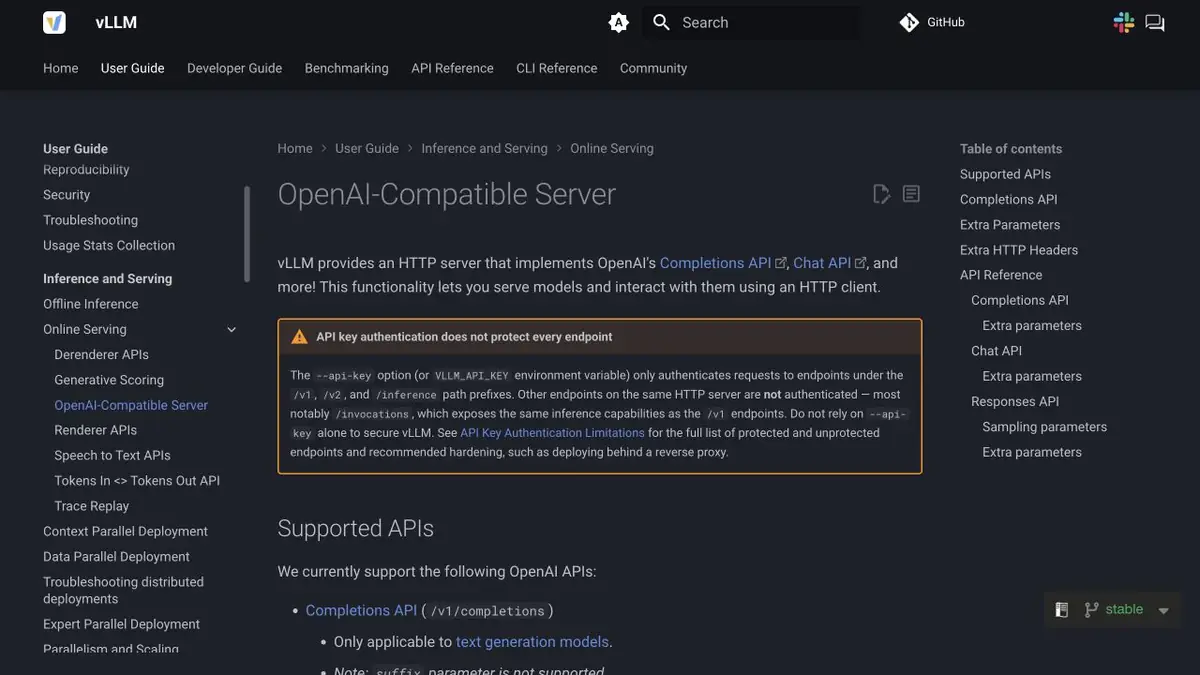
Движок запускает модель на подготовленном оборудовании и обслуживает вызовы нескольких клиентов. Сервер реализует часть интерфейсов OpenAI API.
Сначала один маршрут
Представьте сервис, который раз в час обрабатывает обращения из очереди. Для прототипа хватит одной поддерживаемой модели и маршрута, которым пользуется приложение. vLLM поднимает HTTP сервер, поэтому модель можно проверить тем же клиентом, что стоит в тестовой версии. Начните с короткого запроса и зафиксируйте ожидаемую форму ответа. Если клиенту нужен вызов функции, проверяйте именно его. Поддержка обычного текста не подтверждает работу инструментов.
Почему один быстрый ответ мало что говорит
Нагрузка в очереди приходит неравномерно. Подайте несколько коротких обращений вместе с одним длинным и сравните время до начала ответа и полное время обработки. Запишите размер входов и выходов. Так можно увидеть, связано ли ожидание с чтением большого контекста или с самой генерацией. Если настройки берутся из файлов модели, отметьте это, чтобы не принять изменение параметров за разницу движков.
Ограничения на размещение
Сопоставьте модель и ее формат с документацией vLLM, затем проверьте поведение при входе, который не помещается в контекст. Не открывайте учебный сервер наружу. Документация отдельно описывает границы действия встроенного ключа доступа. Сетевая защита и правила доступа понадобятся еще до испытания на рабочих данных, даже если приложение уже умеет отправлять запросы и читать поток ответа. Отдельно проверьте, что перезапуск возвращает сервер в ожидаемое исходное состояние.
Для каких задач подходит
- Подключить существующий клиент к своей модели
- Измерить задержку при нескольких одновременных запросах
Сильные стороны
- Поддерживает пакетную обработку входящих запросов
- Есть документация сервера и совместимости моделей
Ограничения
- Совместимость интерфейса зависит от маршрута и модели
- Развертывание требует контроля памяти и доступа к сети
Выбор и условия
- Бесплатный режим
- Да
- Пробный период
- Не подтверждено
- Без регистрации
- Не подтверждено
- Русский интерфейс
- Не подтверждено
- Локальная установка
- Да
- API
- Да
«Не подтверждено» означает, что сведений недостаточно. Возможность может существовать; сверяйте условия разработчика.
- Исходные форматы
- Текст, Код
- Результат
- Текст, Данные
Условия
За использование открытого движка нет отдельной подписки. Лицензия модели и вычислительные ресурсы учитываются отдельно. Совместимость интерфейса зависит от маршрута и модели.От задачи к первому результату
Практический пример
- Задача
- Подключить существующий клиент к своей модели
- Что подготовить
- Поддерживаемая модель, тестовый сервер и небольшой набор коротких и длинных запросов.
Задание или запрос
Запусти модель на тестовом сервере. Сравни ответы и время ожидания для одного запроса и для группы одновременных вызовов.
Ожидаемый результат
Таблица задержек, ошибок и настроек запуска с сохраненными входами.
Как проверить результат
- Сверьте настройки генерации и версию весов перед сравнением.
- Проверьте длинный запрос и повтор после ошибки без доступа из открытой сети.
Редакционный учебный пример постановки задачи, а не результат личного тестирования сервиса. Проверьте доступность нужного режима, права на исходники и условия использования результата.
Проверить подробности
Официальные источники
Описание составлено по материалам разработчика. Возможности, цены и доступность могут меняться; перед использованием сверяйтесь с первоисточником.