Die Inferenzsoftware führt ein Modell auf eingerichteter Hardware aus und verarbeitet Anfragen mehrerer Clients. Der Server unterstützt einen Teil der Schnittstellen der OpenAI API.
Zuerst eine Route
Angenommen, ein Dienst verarbeitet einmal pro Stunde Anfragen aus einer Warteschlange. Für einen Prototyp reichen zunächst ein unterstütztes Modell und der Endpunkt, den Ihre Anwendung nutzt. vLLM startet einen HTTP-Server, sodass Sie das Modell mit Ihrem vorhandenen Testclient prüfen können. Senden Sie eine kurze Anfrage und halten Sie das erwartete Antwortformat fest. Prüfen Sie Funktionsaufrufe gezielt, falls der Client sie benötigt. Eine Textantwort allein belegt noch keine funktionierenden Werkzeugaufrufe.
Warum eine schnelle Antwort nicht viel sagt
Die Belastung in der Warteschlange kommt ungleichmäßig. Geben Sie mehrere kurze Anrufe zusammen mit einer langen und vergleichen Sie die Zeit vor Beginn der Antwort und die gesamte Bearbeitungszeit. Notieren Sie sich die Größe der Ein- und Ausgänge. So kann man sehen, ob das Warten mit dem Lesen eines großen Kontextes oder mit der Generation selbst zusammenhängt. Wenn die Einstellungen aus den Modelldateien übernommen werden, aktivieren Sie diese Einstellung, um keine Änderung der Parameter für den Unterschied zwischen den Motoren zu akzeptieren.
Voraussetzungen für die Bereitstellung
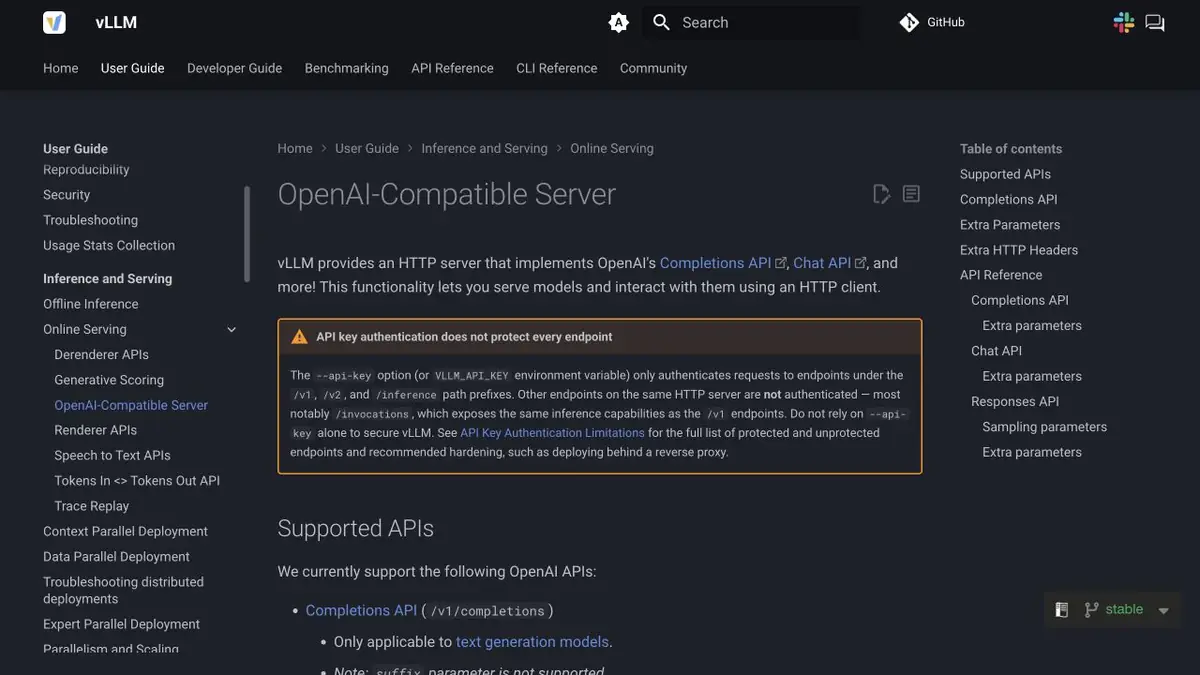
Gleichen Sie Modell und Gewichtsformat mit der vLLM-Dokumentation ab und prüfen Sie dann eine Eingabe, die das Kontextlimit überschreitet. Halten Sie den Testserver privat. Die Dokumentation erläutert, für welche Endpunkte der integrierte Zugriffsschlüssel gilt. Richten Sie Netzwerkschutz und Zugriffsregeln vor einem Test mit echten Daten ein, auch wenn die Anwendung bereits Anfragen senden und gestreamte Antworten lesen kann. Prüfen Sie außerdem, ob der Server nach einem Neustart im erwarteten Ausgangszustand ist.
Für welche Aufgaben geeignet
- Verbinden Sie einen bestehenden Client mit Ihrem Modell
- Verzögerung bei mehreren gleichzeitigen Abfragen messen
Stärken
- Unterstützt Batch-Verarbeitung eingehender Anfragen
- Es gibt eine Dokumentation des Servers und der Kompatibilität der Modelle
Einschränkungen
- Die Kompatibilität hängt vom API-Endpunkt und vom Modell ab
- Beim Betrieb müssen Speicherbedarf und Netzwerkzugriff im Blick bleiben
Auswahl und Bedingungen
- Kostenlose Nutzung
- Ja
- Testphase
- Nicht bestätigt
- Keine Registrierung erforderlich
- Nicht bestätigt
- Russische Benutzeroberfläche
- Nicht bestätigt
- Lokale Installation
- Ja
- API
- Ja
„Nicht bestätigt“ bedeutet, dass nicht genügend Informationen vorliegen. Die Funktion kann dennoch verfügbar sein; prüfen Sie die Angaben des Entwicklers.
- Eingabeformate
- Text, Code
- Ergebnis
- Text, Daten
Bedingungen
Die quelloffene Inferenzsoftware hat kein eigenes Abonnement. Modelllizenz und Rechenkosten sind gesondert zu berücksichtigen. Die Kompatibilität hängt vom API-Endpunkt und vom Modell ab.Von der Aufgabe zum ersten Ergebnis
Praxisbeispiel
- Aufgabe
- Verbinden Sie einen bestehenden Client mit Ihrem Modell
- Was Sie vorbereiten sollten
- Unterstütztes Modell, Testserver und eine kleine Anzahl von kurzen und langen Abfragen.
Aufgabenbeschreibung oder Prompt
Starten Sie das Modell auf dem Testserver. Vergleichen Sie Antworten und Wartezeiten für eine Anfrage und für eine Gruppe gleichzeitiger Anrufe.
Erwartetes Ergebnis
Tabelle mit Verzögerungen, Fehlern und Starteinstellungen mit gespeicherten Eingaben.
So prüfen Sie das Ergebnis
- Überprüfen Sie die Generationseinstellungen und die Version der Waage vor dem Vergleich.
- Überprüfen Sie die lange Abfrage und wiederholen Sie nach dem Fehler ohne Zugriff aus dem offenen Netzwerk.
Ein redaktionelles Lernbeispiel für eine Aufgabenbeschreibung, kein Ergebnis eines eigenen Praxistests des Dienstes. Prüfen Sie die Verfügbarkeit des benötigten Modus, die Rechte am Ausgangsmaterial und die Bedingungen für die Nutzung des Ergebnisses.
Details überprüfen
Offizielle Quellen
Die Beschreibung basiert auf den Materialien des Entwicklers. Die Funktionen, Preise und Verfügbarkeit können variieren. Bitte überprüfen Sie die Quelle vor der Verwendung.