Parseur extrait les champs des e-mails, PDF et images, puis les transmet aux tableaux et applications.
Définir la structure du résultat avant le traitement
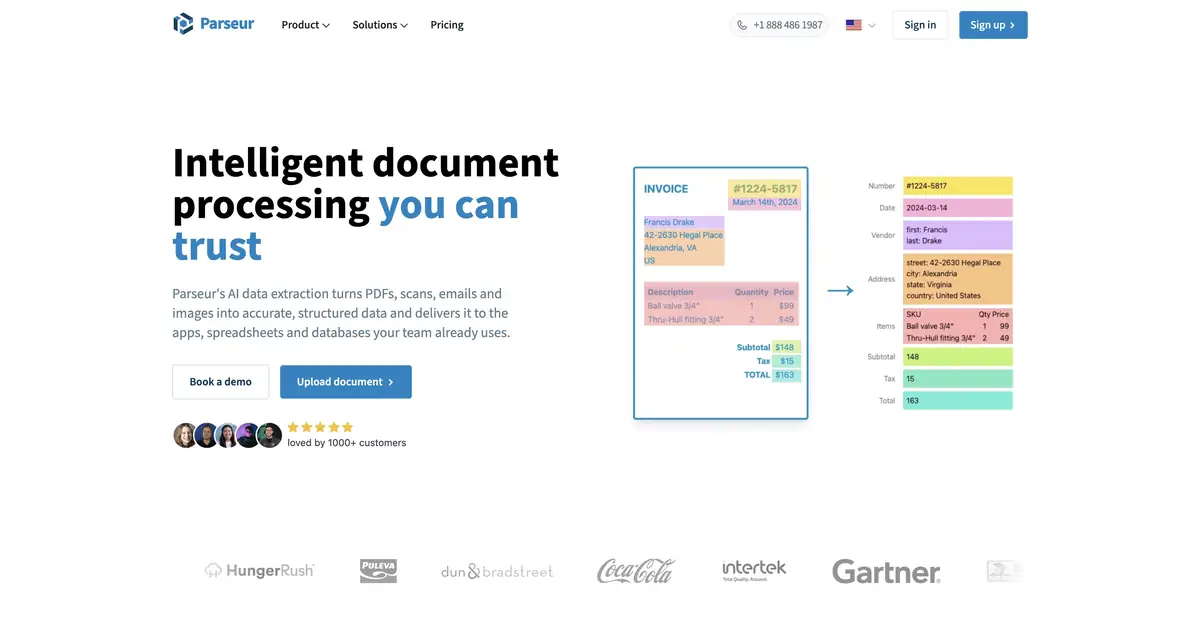
Parseur accepte les documents et le courrier, extrait les champs souhaités et transfère les données à d'autres applications. Dans la description officielle sont séparés Vision AI, Text AI et le travail avec les modèles. Le choix de la méthode dépend du matériau source et de sa stabilité.
Le service est pratique pour les fichiers entrants répétitifs: par exemple, lorsque des informations provenant d'e-mails similaires doivent être collectées dans une table. Mais le nom du champ doit être déterminé à l'avance. Les notions de date d'envoi, de date du document et de délai d'exécution ne sont pas interchangeables, même si elles sont toutes similaires dans le texte.
Vérifier un e-mail, un PDF et une ligne inhabituelle
Pour l’exercice, préparez des documents anonymisés contenant les mêmes types d’informations. Définissez les champs, extrayez les données et comparez-les aux originaux. Ajoutez ensuite un document avec une valeur absente et une autre coupée par un retour à la ligne.
Il est préférable de laisser le champ inconnu vide ou de le diriger vers un contrôle manuel. Si le résultat se trouve dans la feuille de calcul, enregistrez le nom du fichier source et vérifiez les répétitions. Cela permettra de corriger l'erreur et de comprendre quel document l'a provoquée.
Après avoir activé le transfert automatique, testez aussi une défaillance de la destination. Le système externe peut changer ses noms de colonnes ou ses règles de réception. Une extraction réussie ne prouve pas que les données sont correctement enregistrées à la dernière étape.
Paiement et connexion
Parseur propose une offre gratuite récurrente à faible volume et des formules payantes pour davantage de documents. Consultez les limites actuelles du service ; cette fiche ne donne pas de prix fixes. Comptez tout le volume entrant, y compris doublons et fichiers de test.
Le site officiel décrit une API et des intégrations prêtes à l’emploi. Vérifiez votre format, la langue source et la précision des champs requis. Pour des données sensibles, étudiez aussi stockage et accès. L’exercice explique un réglage du processus sans annoncer de précision mesurée.
Pour quelles tâches convient-il
- Extraire les champs des documents entrants
- Rassembler les données dans un tableau
- Vérifier un fichier incomplet ou non standard
Les points forts
- Modes d’IA et modèles pour différents documents
- API et intégrations prêtes à l’emploi
Limites
- Besoin de définitions claires des champs
- Les enregistrements complexes nécessitent une vérification manuelle
Choix et conditions
- Mode gratuit
- Oui
- Période d'essai
- Non confirmé
- Sans inscription
- Non confirmé
- Interface en russe
- Non confirmé
- Installation locale
- Non confirmé
- API
- Oui
« Non confirmé » signifie que les informations disponibles ne suffisent pas. La fonctionnalité peut exister ; vérifiez les conditions du développeur.
- Formats d’entrée
- Document, Image, Texte
- Résultat
- Tableau, Données
Conditions
Définissez champs et destination avant le traitement. L’offre gratuite limite le volume ; vérifiez API, intégrations et modes d’IA pour votre format et les résultats attendus.De la tâche au premier résultat
Exemple pratique
- Tâche
- Extraire les champs des documents entrants
- Que préparer
- Plusieurs de vos fichiers anonymisés contenant des demandes fictives et un tableau des catégories autorisées.
Consigne ou requête
Créez un registre unique des demandes, signalez les doublons et isolez les lignes ambiguës. Conservez le nom du fichier source pour chaque enregistrement. N'inventez pas les dates manquantes, ne supprimez pas les originaux et n'envoyez pas le résultat. Renvoyez un tableau modifiable pour vérification manuelle.
Résultat attendu
Une première version du fichier de registre avec une provenance vérifiable pour chaque ligne ; l'exécution des outils ne garantit pas l'exactitude des données.
Comment vérifier le résultat
- Vérifiez les champs vides, les doublons, les enregistrements multilignes et les totaux.
- Ouvrez le fichier retourné dans le programme cible et vérifiez les formules.
- Limitez l'accès de l'agent aux matériaux nécessaires et vérifiez les actions externes séparément.
Cet exemple pédagogique préparé par la rédaction décrit une tâche ; il ne présente pas le résultat d’un test personnel du service. Vérifiez la disponibilité du mode requis, les droits sur les fichiers d’origine et les conditions d’utilisation du résultat.
Vérifier les détails
Sources officielles
La description est faite à partir des matériaux du développeur. Les fonctionnalités, les prix et la disponibilité peuvent varier; vérifiez la source avant de l'utiliser.